
Дисперсия — это мера рассеяния, описывающая сравнительное отклонение между значениями данных и средней величиной. Является наиболее используемой мерой рассеяния в статистике, вычисляемая путем суммирования, возведенного в квадрат, отклонения каждого значения данных от средней величины. Формула для вычисления дисперсии представлена ниже:

s 2 – дисперсия выборки;
x ср — среднее значение выборки;
n — размер выборки (количество значений данных),
(x i – x ср) — отклонение от средней величины для каждого значения набора данных.
Для лучшего понимания формулы, разберем пример. Я не очень люблю готовку, поэтому занятием этим занимаюсь крайне редко. Тем не менее, чтобы не умереть с голоду, время от времени мне приходится подходить к плите для реализации замысла по насыщению моего организма белками, жирами и углеводами. Набор данных, редставленный ниже, показывает, сколько раз Ренат готовит пищу каждый месяц:
Первым шагом при вычислении дисперсии является определение среднего значения выборки, которое в нашем примере равняется 7,8 раза в месяц. Остальные вычисления можно облегчить с помощью следующей таблицы.

Финальная фаза вычисления дисперсии выглядит так:

Для тех, кто любит производить все вычисления за один раз, уравнение будет выглядеть следующим образом:
Использование метода «сырого счета» (пример с готовкой)
>Существует более эффективный способ вычисления дисперсии, известный как метод «сырого счета». Хотя с первого взгляда уравнение может показаться весьма громоздким, на самом деле оно не такое уж страшное. Можете в этом удостовериться, а потом и решите, какой метод вам больше нравится.

— сумма каждого значения данных после возведения в квадрат,
— квадрат суммы всех значений данных.
Не теряйте рассудок прямо сейчас. Позвольте представить все это в виде таблицы, и тогда вы увидите, что вычислений здесь меньше, чем в предыдущем примере.


Как видите, результат получился тот же, что и при использовании предыдущего метода. Достоинства данного метода становятся очевидными по мере роста размера выборки (n).
Расчет дисперсии в Excel
>Как вы уже, наверное, догадались, в Excel присутствует формула, позволяющая рассчитать дисперсию. Причем, начиная с Excel 2010 можно найти 4 разновидности формулы дисперсии:
1) ДИСП.В – Возвращает дисперсию по выборке. Логические значения и текст игнорируются.
2) ДИСП.Г — Возвращает дисперсию по генеральной совокупности. Логические значения и текст игнорируются.
3) ДИСПА — Возвращает дисперсию по выборке с учетом логических и текстовых значений.
4) ДИСПРА — Возвращает дисперсию по генеральной совокупности с учетом логических и текстовых значений.
Для начала разберемся в разнице между выборкой и генеральной совокупностью. Назначение описательной статистики состоит в том, чтобы суммировать или отображать данные так, чтобы оперативно получать общую картину, так сказать, обзор. Статистический вывод позволяет делать умозаключения о какой-либо совокупности на основе выборки данных из этой совокупности. Совокупность представляет собой все возможные исходы или измерения, представляющие для нас интерес. Выборка — это подмножество совокупности.
Например, нас интересует совокупность группы студентов одного из Российских ВУЗов и нам необходимо определить средний бал группы. Мы можем посчитать среднюю успеваемость студентов, и тогда полученная цифра будет параметром, поскольку в наших расчетах будет задействована целая совокупность. Однако, если мы хотим рассчитать средний бал всех студентов нашей страны, тогда эта группа будет нашей выборкой.
Разница в формуле расчета дисперсии между выборкой и совокупностью заключается в знаменателе. Где для выборки он будет равняться (n-1), а для генеральной совокупности только n.
Теперь разберемся с функциями расчета дисперсии с окончаниями А, в описании которых сказано, что при расчете учитываются текстовые и логические значения. В данном случае при расчете дисперсии определенного массива данных, где встречаются не числовые значения, Excel будет интерпретировать текстовые и ложные логические значения как равными 0, а истинные логические значения как равными 1.
Итак, если у вас есть массив данных, рассчитать его дисперсию ни составит никакого труда, воспользовавшись одной из перечисленных выше функций Excel.

Где σ 2 j - внутригрупповая дисперсия j -й группы.
Для не сгруппированных данных
остаточная дисперсия
– мера точности аппроксимации, т.е. приближения линии регрессии к исходным данным:
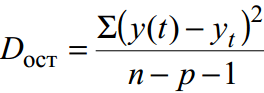
где y(t) – прогноз по уравнению тренда; y t – исходный ряд динамики; n – количество точек; p – число коэффициентов уравнения регрессии (количество объясняющих переменных).
В этом примере она называется несмещенная оценка дисперсии
.
Пример №1 . Распределение рабочих трех предприятий одного объединения по тарифным разрядам характеризуется следующими данными:
| Тарифный разряд рабочего | Численность рабочих на предприятии | ||
| предприятие 1 | предприятие 2 | предприятие 3 | |
| 1 | 50 | 20 | 40 |
| 2 | 100 | 80 | 60 |
| 3 | 150 | 150 | 200 |
| 4 | 350 | 300 | 400 |
| 5 | 200 | 150 | 250 |
| 6 | 150 | 100 | 150 |
Определить:
1. дисперсию по каждому предприятию (внутригрупповые дисперсии);
2. среднюю из внутригрупповых дисперсий;
3. межгрупповую дисперсию ;
4. общую дисперсию.
Решение.
Прежде чем приступить к решению задачи необходимо выяснить, какой признак является результативным, а какой – факторным. В рассматриваемом примере результативным признаком является «Тарифный разряд», а факторным признаком – «Номер (название) предприятия».
Тогда имеем три группы (предприятия), для которых необходимо рассчитать групповую среднюю и внутригрупповые дисперсии :

| Предприятие | Групповая средняя, | Внутригрупповая дисперсия, |
| 1 | 4 | 1,8 |
Средняя из внутригрупповых дисперсий (остаточная дисперсия ) рассчитаем по формуле:
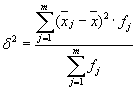
где можно рассчитать:
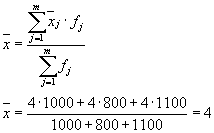
либо:
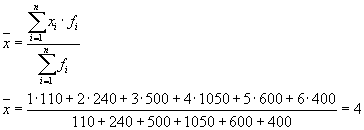
тогда:
Общая дисперсия будет равна: s 2 = 1,6 + 0 = 1,6.
Общую дисперсию также можно рассчитать и по одной из следующих двух формул:
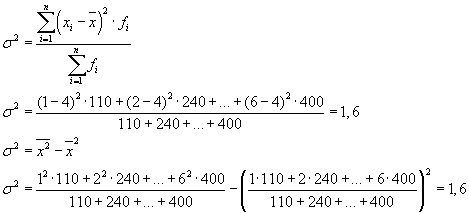
При решении практических задач часто приходится иметь дело с признаком, принимающим только два альтернативных значения. В этом случае говорят не о весе того или иного значения признака, а о его доле в совокупности. Если долю единиц совокупности, обладающих изучаемым признаком, обозначить через «р
», а не обладающих – через «q
», то дисперсию можно рассчитать по формуле:
s 2 = p×q
Пример №2 . По данным о выработке шести рабочих бригады определить межгрупповую дисперсию и оценить влияние рабочей смены на их производительность труда, если общая дисперсия равна 12,2 .
| № рабочего бригады | Выработка рабочего, шт. | |
| в I смену | во II смену | |
| 1 | 18 | 13 |
| 2 | 19 | 14 |
| 3 | 22 | 15 |
| 4 | 20 | 17 |
| 5 | 24 | 16 |
| 6 | 23 | 15 |
Решение . Исходные данные
| X | f 1 | f 2 | f 3 | f 4 | f 5 | f 6 | Итого |
| 1 | 18 | 19 | 22 | 20 | 24 | 23 | 126 |
| 2 | 13 | 14 | 15 | 17 | 16 | 15 | 90 |
| Итого | 31 | 33 | 37 | 37 | 40 | 38 |
Тогда имеем 6 группы, для которых необходимо рассчитать групповую среднюю и внутригрупповые дисперсии.
1. Находим средние значения каждой группы .
2. Находим среднее квадратическое каждой группы .
Результаты расчета сведем в таблицу:
| Номер группы | Групповая средняя | Внутригрупповая дисперсия |
| 1 | 1.42 | 0.24 |
| 2 | 1.42 | 0.24 |
| 3 | 1.41 | 0.24 |
| 4 | 1.46 | 0.25 |
| 5 | 1.4 | 0.24 |
| 6 | 1.39 | 0.24 |
3. Внутригрупповая дисперсия характеризует изменение (вариацию) изучаемого (результативного) признака в пределах группы под действием на него всех факторов, кроме фактора, положенного в основание группировки:
Среднюю из внутригрупповых дисперсий рассчитаем по формуле:
4. Межгрупповая дисперсия характеризует изменение (вариацию) изучаемого (результативного) признака под действием на него фактора (факторного признака), положенного в основание группировки.
Межгрупповую дисперсию определим как:
где
Тогда
Общая дисперсия характеризует изменение (вариацию) изучаемого (результативного) признака под действием на него всех без исключения факторов (факторных признаков). По условию задачи она равна 12.2 .
Эмпирическое корреляционное отношение измеряет, какую часть общей колеблемости результативного признака вызывает изучаемый фактор. Это отношение факторной дисперсии к общей дисперсии:
Определяем эмпирическое корреляционное отношение:
Связи между признаками могут быть слабыми и сильными (тесными). Их критерии оцениваются по шкале Чеддока:
0.1 0.3 0.5 0.7 0.9 В нашем примере связь между признаком Y фактором X слабая
Коэффициент детерминации.
Определим коэффициент детерминации:
Таким образом, на 0.67% вариация обусловлена различиями между признаками, а на 99.37% – другими факторами.
Вывод : в данном случае выработка рабочих не зависит от работы в конкретную смену, т..е. влияние рабочей смены на их производительность труда не значительное и обусловлено другими факторами.
Пример №3 . На основе данных о средней заработной плате и квадратах отклонений от её величины по двум группам рабочих найти общую дисперсию, применив правило сложения дисперсий:
Решение:Средняя из внутригрупповых дисперсий

Межгрупповую дисперсию определим как:

Общая дисперсия будет равна: 480 + 13824 = 14304
Во многих случаях возникает необходимость ввести ещё одну числовую характеристику для измерения степени рассеивания, разброса значений , принимаемых случайной величиной ξ , вокруг её математического ожидания.
Определение. Дисперсией случайной величины ξ называется число.
D ξ = M(ξ-M ξ) 2 . (1)
Другими словами, дисперсия есть математическое ожидание квадрата отклонения значений случайной величины от её среднего значения.
называется средним квадратичным отклонением
величины ξ .
Если дисперсия характеризует средний размер квадрата отклонения ξ oт Mξ , то число можно рассматривать как некоторую среднюю характеристику самого отклонения, точнее, величины | ξ-Mξ |.
Из определения (1) вытекают следующие два свойства дисперсии.
1. Дисперсия постоянной величины равна нулю. Это вполне соответствует наглядному смыслу дисперсии, как «меры разброса».
Действительно, если
ξ = С, то Mξ = C и, значит Dξ = M(C-C ) 2 = M 0 = 0.
2. При умножении случайной величины ξ на постоянное число С её дисперсия умножается на C 2
D(Cξ ) = C 2 Dξ . (3)
Действительно
D(Cξ) = M(C
= M(C .
3. Имеет место, следующая формула для вычисления дисперсии:
. (4)
Доказательство этой формулы следует из свойств математического ожидания.
Мы имеем:
4. Если величины ξ 1 и ξ 2 независимы, то дисперсия их суммы равна сумме их дисперсий:
Доказательство . Для доказательства используем свойства математического ожидания. Пусть Mξ 1 = m 1 , Mξ 2 = m 2 , тогда.
Формула (5) доказана.
Так как дисперсия случайной величины есть по определению математическое ожидание величины (ξ -m ) 2 , где m = Mξ , то для вычисления дисперсии можно воспользоваться формулами, полученными в §7 гл.II.
Так, если ξ есть ДСВ с законом распределения
| x 1 | x 2 | ... |
| p 1 | p 2 | ... |
то будем иметь:
. (7)
Если ξ непрерывна случайная величина с плотностью распределения p(x) , тогда получим:
Dξ = . (8)
Если использовать формулу (4) для вычисления дисперсии, то можно получить другие формулы, а именно:
, (9)
если величина ξ дискретна, и
Dξ = , (10)
если ξ распределена с плотностью p (x ).
Пример 1 . Пусть величина ξ равномерно распределена на отрезке [a,b ]. Воспользовавшись формулой (10) получим:
Можно показать, что дисперсия случайной величины , распределенной по нормальному закону с плотностью
p(x) = , (11)
равна σ 2 .
Тем самым выясняется смысл параметра σ, входящего в выражение плотности (11) для нормального закона; σ ecть среднее квадратичное отклонение величины ξ .
Пример 2 . Найти дисперсию случайной величины ξ , распределенной по биномиальному закону.
Решение . Воспользовавшись представлением ξ в виде
ξ = ξ 1 + ξ 2 + ξ n (см. пример 2 §7 гл. II) и применяя формулу сложения дисперсий для независимых величин, получим
Dξ = Dξ 1 + Dξ 2 + Dξ n .
Дисперсия любой из величин ξ i (i = 1,2, n ) подсчитывается непосредственно:
Dξ i = M(ξ i ) 2 - (Mξ i ) 2 = 0 2 · q + 1 2 p - p 2 = p (1-p ) = pq .
Окончательно получаем
Dξ = npq , где q = 1 - p .
Математическим ожиданием (средним значением) случайной величины X , заданной на дискретном вероятностном пространстве, называется число m =M[X]=∑x i p i , если ряд сходится абсолютно.
Назначение сервиса . С помощью сервиса в онлайн режиме вычисляются математическое ожидание, дисперсия и среднеквадратическое отклонение (см. пример). Кроме этого строится график функции распределения F(X) .
Свойства математического ожидания случайной величины
>- Математическое ожидание постоянной величины равно ей самой: M[C]=C , C – постоянная;
- M=C M[X]
- Математическое ожидание суммы случайных величин равно сумме их математических ожиданий: M=M[X]+M[Y]
- Математическое ожидание произведения независимых случайных величин равно произведению их математических ожиданий: M=M[X] M[Y] , если X и Y независимы.
Свойства дисперсии
>- Дисперсия постоянной величины равна нулю: D(c)=0.
- Постоянный множитель можно вынести из-под знака дисперсии, возведя его в квадрат: D(k*X)= k 2 D(X).
- Если случайные величины X и Y независимы, то дисперсия суммы равна сумме дисперсий: D(X+Y)=D(X)+D(Y).
- Если случайные величины X и Y зависимы: D(X+Y)=DX+DY+2(X-M[X])(Y-M[Y])
- Для дисперсии справедлива вычислительная формула:
D(X)=M(X 2)-(M(X)) 2
Пример
. Известны математические ожидания и дисперсии двух независимых случайных величин X и Y: M(x)=8 , M(Y)=7 , D(X)=9 , D(Y)=6 . Найти математическое ожидание и дисперсию случайное величины Z=9X-8Y+7 .
Решение. Исходя из свойств математического ожидания: M(Z) = M(9X-8Y+7) = 9*M(X) - 8*M(Y) + M(7) = 9*8 - 8*7 + 7 = 23.
Исходя из свойств дисперсии: D(Z) = D(9X-8Y+7) = D(9X) - D(8Y) + D(7) = 9^2D(X) - 8^2D(Y) + 0 = 81*9 - 64*6 = 345
Алгоритм вычисления математического ожидания
> Свойства дискретных случайных величин: все их значения можно перенумеровать натуральными числами; каждому значению сопоставить отличную от нуля вероятность.- Поочередно умножаем пары: x i на p i .
- Складываем произведение каждой пары x i p i .
Например, для n = 4: m = ∑x i p i = x 1 p 1 + x 2 p 2 + x 3 p 3 + x 4 p 4
Пример №1 .
| x i | 1 | 3 | 4 | 7 | 9 |
| p i | 0.1 | 0.2 | 0.1 | 0.3 | 0.3 |
Математическое ожидание находим по формуле m = ∑x i p i .
Математическое ожидание M[X] .
M[x] = 1*0.1 + 3*0.2 + 4*0.1 + 7*0.3 + 9*0.3 = 5.9
Дисперсию находим по формуле d = ∑x 2 i p i - M[x] 2 .
Дисперсия D[X] .
D[X] = 1 2 *0.1 + 3 2 *0.2 + 4 2 *0.1 + 7 2 *0.3 + 9 2 *0.3 - 5.9 2 = 7.69
Среднее квадратическое отклонение σ(x) .
σ = sqrt(D[X]) = sqrt(7.69) = 2.78
Пример №2 . Дискретная случайная величина имеет следующий ряд распределения:
| Х | -10 | -5 | 0 | 5 | 10 |
| р | а | 0,32 | 2a | 0,41 | 0,03 |
Решение. Величину a находим из соотношения: Σp i = 1
Σp i = a + 0,32 + 2 a + 0,41 + 0,03 = 0,76 + 3 a = 1
0.76 + 3 a = 1 или 0.24=3 a , откуда a = 0.08
Пример №3
. Определить закон распределения дискретной случайной величины, если известна её дисперсия, причем х 1
p 1 =0,3; p 2 =0,3; p 3 =0,1; p 4 =0,3
d(x)=12,96
Решение.
Здесь надо составить формулу нахождения дисперсии d(x) :
d(x) = x 1 2 p 1 +x 2 2 p 2 +x 3 2 p 3 +x 4 2 p 4 -m(x) 2
где матожидание m(x)=x 1 p 1 +x 2 p 2 +x 3 p 3 +x 4 p 4
Для наших данных
m(x)=6*0,3+9*0,3+x 3 *0,1+15*0,3=9+0.1x 3
12,96 = 6 2 0,3+9 2 0,3+x 3 2 0,1+15 2 0,3-(9+0.1x 3) 2
или -9/100 (x 2 -20x+96)=0
Соответственно надо найти корни уравнения, причем их будет два.
x 3 =8, x 3 =12
Выбираем тот, который удовлетворяет условию х 1
Закон распределения дискретной случайной величины
x 1 =6; x 2 =9; x 3 =12; x 4 =15
p 1 =0,3; p 2 =0,3; p 3 =0,1; p 4 =0,3





